Go-live de un CMMS: qué tiene que estar listo y cómo sostener los primeros 30 días
Criterios go/no-go para arrancar un CMMS: qué bloquea, qué hacer con las OT abiertas el día D, cómo clasificar incidencias y cuándo cerrar la estabilización.
Faltan cuatro días para la fecha que se le comprometió a la gerencia. La configuración está cerrada, los técnicos aprobaron la capacitación y el entorno de prueba muestra órdenes. Pero los preventivos de la línea 3 todavía no están cargados, dos supervisores del turno noche no tienen usuario y la planilla de OT sigue recibiendo pedidos porque “hasta el lunes vale”. En la reunión de seguimiento aparece la pregunta de siempre: ¿arrancamos igual o postergamos?
Esa pregunta no se responde mirando el calendario. El go-live de un CMMS se decide con criterios. Hay un grupo chico de condiciones que, si fallan, bloquean el arranque, y un grupo más grande que puede quedar pendiente siempre que tenga responsable y plazo. Lo que no bloquea pasa a un plan de estabilización que se revisa todos los días durante las primeras semanas.
Esta guía sobre la puesta en marcha arranca donde termina el trabajo de configuración, datos y capacitación que se desarrolla en cómo implementar un CMMS sin frenar la operación. Cubre la reunión go/no-go, el día del corte, el soporte de la primera semana, la clasificación de incidencias y el criterio para dar por estabilizado el sistema.
Qué significa hacer go-live en un CMMS (y qué no)
Hacer go-live significa que, a partir de una fecha y hora definidas, el CMMS pasa a ser el registro oficial del trabajo de mantenimiento dentro del alcance acordado. Lo que no está en el sistema no consta como hecho. En ese alcance las planillas dejan de recibir datos y la reunión operativa se arma con lo que muestra el sistema.
Un piloto también tiene su go-live: dentro de su alcance, el registro cambia de lugar y las planillas se congelan. El rollout repite ese paso en otras áreas o plantas. En los dos casos, go-live es el momento en que el registro oficial pasa al sistema. Puede ser parcial (una planta, un área o solo correctivos y preventivos) y muchas veces conviene que lo sea. En una operación multiplanta, cada sitio repite su propia decisión go/no-go.
Tampoco cierra el proyecto. Las primeras semanas en producción son las que más decisiones de configuración generan, porque recién ahí aparecen el turno noche, el contratista sin usuario y la OT que se abrió en papel durante un corte de red.
Criterios go/no-go: qué bloquea el arranque y qué puede esperar
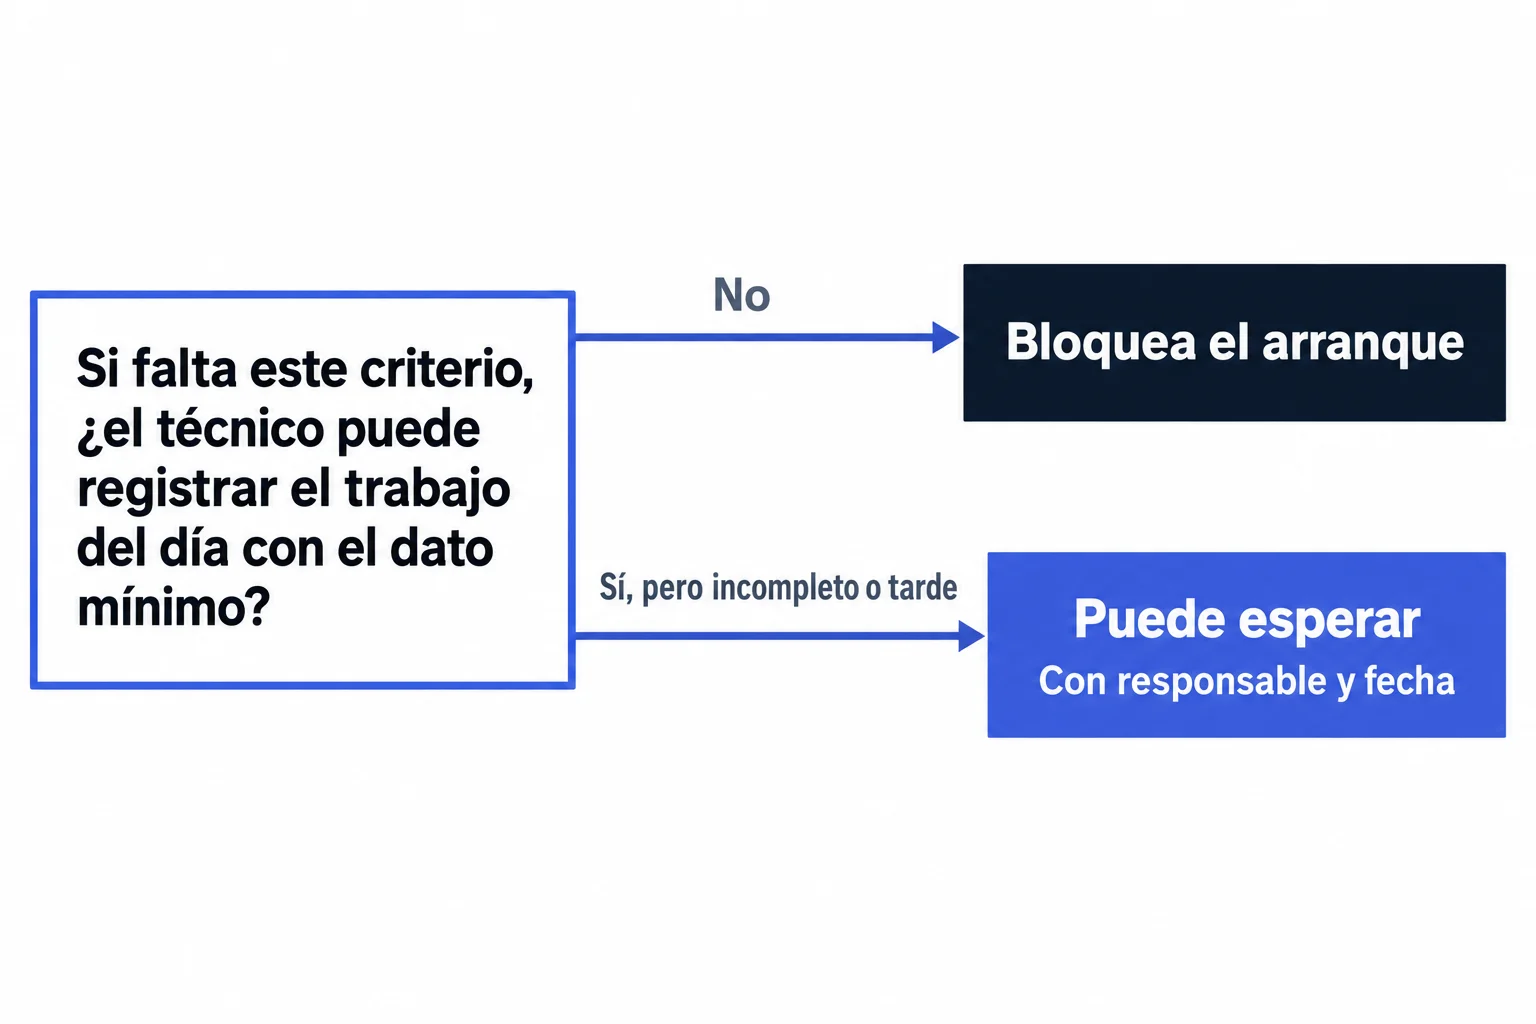
Para separar lo bloqueante de lo pendiente sirve una prueba simple: si esto falta, ¿un técnico del alcance puede registrar el trabajo del día con el dato mínimo que necesita el historial? Si la respuesta es no, el criterio bloquea. Si el trabajo se puede registrar pero algún dato llega incompleto o tarde, el criterio puede esperar, a condición de que tenga un responsable y una fecha.
| Criterio | ¿Bloquea? | Cómo se verifica |
|---|---|---|
| Activos críticos del alcance cargados, con jerarquía y código único | Sí | Elegir una muestra de activos del área (por ejemplo, diez) y buscarlos desde el móvil por código o QR. Ninguno puede faltar ni aparecer duplicado. |
| Usuarios activos en todos los turnos, incluidos supervisores de noche, guardias y contratistas que registran | Sí | Cruzar la dotación por turno con la lista de usuarios. Cada persona ingresa al menos una vez antes del día D, con su propio dispositivo o con el asignado. |
| Flujo de OT probado de punta a punta | Sí | Un correctivo y un preventivo creados, asignados, ejecutados, cerrados y aprobados por usuarios reales del alcance, no por el implementador. |
| Regla para urgencias | Sí | Escrita y comunicada: quién abre la OT de una urgencia, en qué momento y con qué detalle mínimo cuando no hay tiempo de cargarla antes de intervenir. |
| Dispositivos y conectividad en los puntos de trabajo | Sí, si los técnicos cierran desde campo | Prueba en los lugares donde se trabaja (sala de compresores, cámaras de frío, techos, subestación), incluida la sincronización sin señal. |
| Competencias mínimas validadas por rol | Sí para técnicos y supervisores del alcance | Evidencia del ejercicio aprobado. Quien no lo aprobó entra con acompañamiento documentado o queda fuera del alcance inicial. |
| Decisión sobre las planillas | Sí | Fecha y hora de congelamiento, quién las pasa a solo lectura y dónde quedan archivadas. |
| Preventivos del alcance con su próxima fecha | Depende | Bloquean los preventivos legales, de seguridad o exigidos por auditoría. El resto puede cargarse en la primera semana con responsable y fecha. |
| Stock de repuestos críticos | No, si la OT permite imputar el consumo después | Lista de repuestos críticos con fecha de carga. Mientras tanto, el consumo se anota en la OT para imputarlo después. |
| Integración con ERP | No, salvo que compras, costos o stock dependan de ella desde el día 1 | Si no está lista, se define quién concilia manualmente y con qué frecuencia. |
| Historial anterior | No | Se consulta en el archivo de origen hasta que se decida qué parte se migra. |
| Tableros y KPI | No | Durante las primeras semanas los datos describen el arranque más que la operación. Los indicadores se construyen después. |
Con la escena del principio, la tabla resuelve la discusión. Los preventivos de la línea 3 pueden esperar si ninguno es legal ni de seguridad y alguien se compromete a cargarlos en los primeros cinco días hábiles. Los dos supervisores del turno noche sin usuario bloquean: si nadie puede aprobar cierres de noche, las OT de ese turno quedan abiertas o las aprueba alguien que no vio el trabajo. Y la planilla que sigue recibiendo pedidos también bloquea mientras no haya una hora concreta para congelarla.
Algunos criterios dependen del trabajo previo. Qué datos tienen que estar cargados se detalla en el checklist de datos mínimos para implementar un CMMS. Cómo se valida la competencia de cada perfil está en el plan de capacitación CMMS por roles. Si los técnicos trabajan en zonas sin señal, la guía sobre cuándo la operación offline es un requisito explica qué probar.
El checklist al final del artículo reúne estos criterios en una hoja para llevar a la reunión de decisión.
Quién toma la decisión y con qué evidencia
La reunión go/no-go conviene hacerla con unos días de margen antes del día D. Si se hace la víspera, ya no queda margen para corregir lo que falla. Decide el sponsor y presenta el líder funcional de mantenimiento. Participan IT, el implementador y al menos un supervisor por turno: son quienes saben si su gente puede registrar. La matriz RACI de una implementación CMMS detalla quién aprueba el arranque y a quién se consulta.
A esa reunión se lleva la matriz con cada criterio verificado. “En curso” no cuenta como estado para un criterio bloqueante. Hay tres resultados posibles:
| Resultado | Qué implica |
|---|---|
| Go | Todos los bloqueantes se cumplen. Se confirman fecha, hora de corte y cobertura de soporte. |
| Go con condiciones | Los bloqueantes se cumplen y los pendientes quedan en una lista con responsable y fecha, que se revisa en la reunión diaria de la primera semana. |
| No-go | Hay una fecha nueva atada a los criterios que fallaron, cada uno con responsable y forma de verificación. |
Un no-go que solo dice “lo pasamos dos semanas” suele terminar en la misma reunión con el mismo resultado.
El día D: corte, OT en curso y planillas
El corte es el momento en que el registro cambia de lugar. Lo que esté abierto en ese momento necesita una regla, porque si no cada técnico va a decidir solo dónde carga lo que tenía entre manos.
| Situación al momento del corte | Decisión recomendada |
|---|---|
| OT correctiva en ejecución | Si termina antes del corte, se cierra en origen. Si sigue abierta, se crea en el CMMS con referencia al número de la planilla y se cierra ahí, con las horas y repuestos completos. |
| OT pendientes (backlog) | Se cargan como backlog con prioridad revisada. Las que nadie puede explicar ni asignar se depuran antes del corte, no después. |
| Preventivos vencidos | Se cargan vencidos y visibles, o se reprograman con un criterio explícito. Borrarlos para "arrancar limpio" le quita al planner una información que necesita. |
| Cambios posteriores a la última carga de datos | Activos dados de alta, repuestos movidos o equipos reubicados desde la última foto de datos forman un delta que se carga antes del corte. |
| Pedidos que llegan por WhatsApp o por radio | Se atienden, y el referente de turno los convierte en solicitud dentro del sistema. Se le comunica a producción por qué canal pedir trabajo desde el día D. |
| Planillas del alcance | Pasan a solo lectura, se archivan con la fecha de corte y se le quita la edición a quien las mantenía. |
En una planta de manufactura con tres turnos, la hora del corte también decide quién vive el primer día. Si el corte es el lunes a las 6:00, el turno noche del domingo cierra en la planilla y el turno mañana abre todo en el sistema, con el líder funcional y el implementador presentes. El problema aparece esa misma noche: el primer turno noche en el CMMS es el que menos acompañamiento tiene. Por eso el referente de noche tiene que estar en planta esa primera guardia, no disponible “para mañana”.
Las reglas para que nadie cargue dos veces durante la transición se desarrollan en la sección de rollout sin duplicar trabajo. Acá interesa el momento puntual del cambio.
Plan de contingencia si el sistema o la conectividad fallan
Lo que se busca con la contingencia es no perder el registro, sin volver a la planilla. Alcanza con un formulario de respaldo, en papel o digital, con los mismos campos mínimos que la OT: activo, síntoma, acción, repuesto, horas y técnico. Conviene que esté numerado, para saber cuántos se usaron. Lo carga en el sistema el referente del turno, en el mismo turno o en el siguiente, y al cierre de la semana se cuentan los formularios emitidos y los cargados.
Si la app trabaja sin conexión, la contingencia cubre otros casos: dispositivo sin batería, usuario bloqueado o falla del servicio. Si un turno entero termina en formularios de respaldo, es una incidencia bloqueante y se trata como tal.
Soporte en la primera semana: referentes, canal y horarios
El soporte intensivo de la primera semana (lo que en proyectos de software se llama hypercare) tiene que llegar a donde se trabaja y cubrir los mismos horarios que la operación. En el horario central el soporte casi siempre está. Las dudas sin respuesta aparecen el sábado a la tarde o a las tres de la mañana.
| Turno o grupo | Quién atiende en el lugar | A quién escala |
|---|---|---|
| Mañana | Usuario clave del turno y líder funcional | Implementador del proveedor |
| Tarde | Usuario clave del turno | Líder funcional; implementador si es una falla del sistema |
| Noche y fin de semana | Referente de turno | Guardia telefónica del líder funcional; lo que no es urgente se registra y se resuelve en el turno mañana |
| Contratistas | Supervisor interno que los recibe | Administrador funcional si el problema es de acceso o permisos |
Las consultas tienen que llegar por un canal único y quedar anotadas en un registro de incidencias: fecha, usuario, turno, descripción y, después, tipo y resolución. Un grupo de WhatsApp sirve para avisar rápido, pero cada mensaje tiene que pasar al registro. Sin ese registro no hay forma de saber, en la semana 2, qué se repite.
Un detalle: el referente acompaña, no carga por otros. Si el usuario clave registra con su usuario las OT de todo el turno, el sistema muestra actividad pero oculta quién todavía no puede registrar solo.
Cómo clasificar las incidencias del arranque
“El sistema no anda” puede ser un activo que no está cargado, un permiso mal asignado, un campo que no aplica, un usuario que no sabe registrar una pausa o una tablet sin señal en la cámara de frío. Si no se clasifica la incidencia, todo termina en un ticket al proveedor o en otra sesión de capacitación, y ninguna de las dos cosas resuelve la mayoría de los casos.
La lógica de causas que sirve para evaluar la capacitación antes del go-live se usa acá con otro objetivo: decidir quién resuelve y si hace falta tocar la configuración.
| Tipo | Ejemplo | Quién resuelve | ¿Toca la configuración? |
|---|---|---|---|
| Dato | "No encuentro la bomba P-204", activo duplicado | Responsable de datos del dominio | No. Se corrige el maestro; no se crea un activo nuevo desde la OT para salir del paso. |
| Permiso | "No me deja cerrar", "no veo las OT de mi área" | Administrador funcional | Sí, el perfil, con aprobación del líder funcional. |
| Configuración | Campo obligatorio que no aplica, estado que falta | Líder funcional con el implementador | Sí, en la ventana semanal de cambios. |
| Capacitación | "No sé cómo cargar una pausa por falta de repuesto" | Referente de turno | No. Acompañamiento en el momento y, si se repite en varios usuarios, refuerzo dirigido. |
| Conectividad o dispositivo | No sincroniza en una zona, batería agotada | IT | No. Solución técnica y nueva prueba en el lugar. |
| Proceso | El flujo diseñado no refleja cómo se trabaja | Sponsor y líder funcional | Después: primero se decide el proceso. |
| Falla del sistema | Error o comportamiento distinto al documentado | Proveedor | No. Ticket con evidencia: usuario, hora, pantalla y paso. |
La clasificación cambia la respuesta. Un técnico del turno noche reporta que no puede cerrar una OT. A primera vista es un permiso. Al revisarlo, el flujo exige aprobación del supervisor y de noche no hay supervisor de mantenimiento en planta: la incidencia es de proceso. Hay que decidir si de noche aprueba el jefe de turno de producción, si la OT queda en estado “ejecutada” hasta la mañana o si se habilita a un técnico senior. Darle permisos de aprobación al técnico que reportó para que deje de llamar resuelve la noche y rompe el control. Cómo diseñar quién crea, cierra y aprueba cada OT se desarrolla en roles y permisos en un CMMS.
Severidad: qué se arregla hoy y qué va a la lista de ajustes
El nivel intermedio es el que más se subestima. Supongamos que el flujo no permite pausar una OT por falta de repuesto y el técnico la deja abierta hasta que llega el sello. El tiempo de reparación absorbe días de espera, y el MTTR que después se calcule va a mezclar la intervención con la logística. Nadie lo nota en la primera semana, pero queda en el historial.
Lo que no bloquea se agrupa y se aplica en una ventana semanal de cambios, comunicada siempre el mismo día. Reconfigurar todos los días durante la primera semana desorienta a usuarios que fueron capacitados con otra versión, y vuelve difícil saber si un problema nuevo lo causó el último cambio.
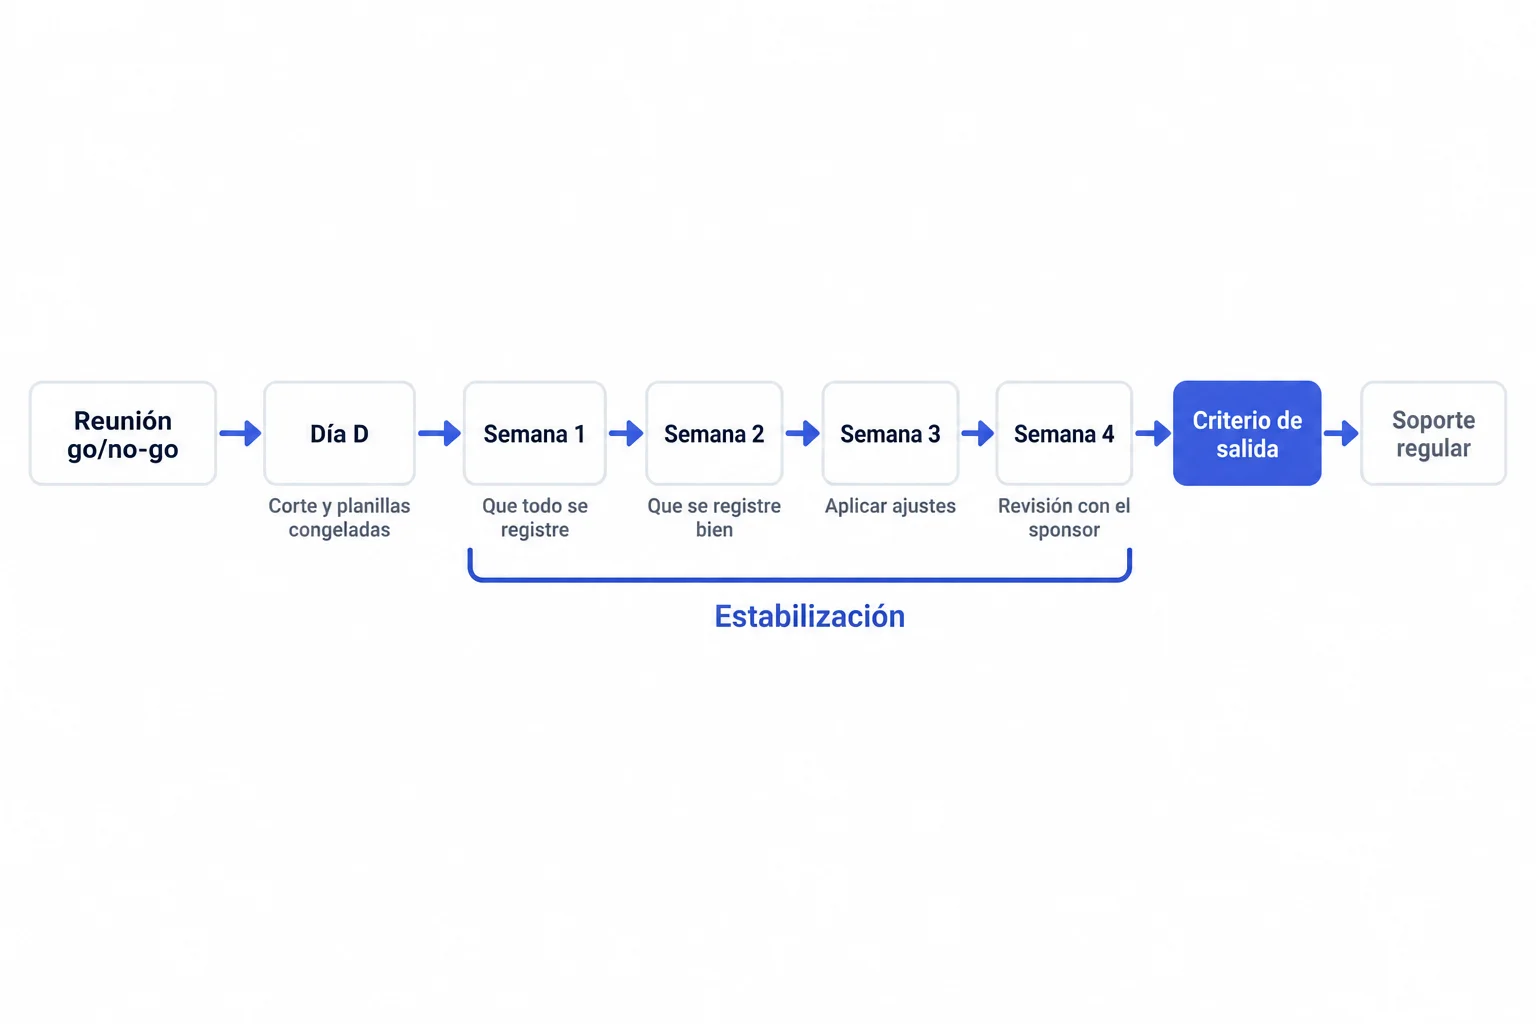
Los primeros 30 días, semana a semana
Cada semana tiene un foco distinto y unas pocas señales que se pueden observar. No hacen falta umbrales universales: cada operación compara contra su propio volumen de trabajo. Un porcentaje de “uso” no dice si el trabajo del turno noche está entrando al sistema.
Revisión diaria breve al cambio de turno, con el líder funcional, los referentes y el implementador. Se miran tres cosas: trabajos que aparecen en el parte de producción o en el libro de guardia y no en el sistema, incidencias abiertas por tipo y severidad, y formularios de contingencia pendientes de carga.
El foco pasa a la calidad del cierre. El supervisor revisa una muestra de OT cerradas: causa, acción, horas, repuestos imputados y evidencia. Los errores repetidos se clasifican antes de decidir si son capacitación o configuración. La revisión puede pasar a día por medio.
Se aplica la lista de ajustes (campos obligatorios, catálogos de falla, permisos, estados) y se comunica a todos los turnos. El planner compara los preventivos generados con los ejecutados para detectar frecuencias mal cargadas o rutinas que nadie recibe.
Se contrasta el estado contra el criterio de salida. Hay dos resultados posibles: se cierra la estabilización o se extiende con un foco explícito y una fecha de revisión.
Pasados los 30 días, la pregunta cambia: el sistema ya registra, y lo que queda por ver es si el hábito se sostiene. Eso se trabaja con otras herramientas, que se desarrollan en la guía sobre cómo sostener la adopción del CMMS en el equipo técnico.
Señales de que la estabilización no avanza
Cualquiera de estas señales justifica tratar el tema por separado en la revisión semanal, con un responsable, en vez de esperar a la semana 4.
Cuándo termina la estabilización
Treinta días es un horizonte de revisión. La estabilización termina cuando se cumplen condiciones concretas, y eso puede pasar antes o después.
El traspaso es la condición que más se olvida. Cuando el proyecto se disuelve sin que nadie herede la responsabilidad sobre los datos y la configuración, a los pocos meses aparecen activos creados por cualquiera y campos obligatorios agregados a pedido. Cómo se reparten esas responsabilidades se explica en qué pasa con el equipo después del arranque.
Si en la semana 4 faltan condiciones, la estabilización se extiende con un foco explícito (“cerrar la calidad de cierre del turno tarde”, “terminar la carga de preventivos de la línea 3”) y una fecha de revisión, sin dejarla abierta de manera indefinida. Medir si la implementación logró lo que se buscaba es otra discusión, que se apoya en otros indicadores.
Checklist go-live: preparación y primeros 30 días
Dejá tu email y te lo mandamos, para llevarlo a la reunión go/no-go y usarlo durante las primeras semanas en producción.
Al enviar tu email aceptás nuestra Política de Privacidad.
Si el arranque va a tener acompañamiento del proveedor, conviene revisar estos puntos con ese equipo antes de fijar la fecha. Cómo trabaja OTEX esa etapa se describe en servicios de implementación.
Prepará el arranque con el equipo que lo va a acompañar
Revisá los criterios go/no-go, las reglas del día D y la cobertura de soporte por turno antes de comprometer la fecha de salida a producción.