KPI de implementación CMMS: cómo medir adopción, calidad de datos y control operativo
Qué medir tras el go-live de un CMMS para decidir si cortar la planilla paralela o extender el rollout: adopción, calidad de datos y control a 30/60/90 días.
Reunión de seguimiento, día 60 después del go-live. El implementador proyecta dos números: 42 usuarios activos y 1.180 órdenes de trabajo creadas desde el arranque. El gerente de planta hace la única pregunta que le importa: ¿podemos dar de baja la planilla de preventivos y pasar a la línea 2? Nadie en la mesa puede contestar con datos. Las 1.180 OT prueban que hubo actividad en el sistema. No dicen cuántos trabajos quedaron afuera, cuántas OT están imputadas al activo equivocado ni si el supervisor sigue armando la semana desde el Excel.
Los KPI de una implementación CMMS no son los indicadores de mantenimiento ni los accesos al sistema. Responden tres preguntas encadenadas: si el trabajo real se registra en el sistema (adopción), si lo registrado sirve para decidir (calidad de datos) y si el equipo gestiona desde ahí (control operativo). Cada pregunta necesita pocos indicadores, con definición, fuente y un criterio de salida que habilite una decisión concreta: cortar la doble carga, extender el rollout o cerrar el acompañamiento intensivo.
Este artículo empieza donde termina el arranque. Cómo ordenar las fases y qué cargar primero está desarrollado en la guía para implementar un CMMS sin frenar la operación. Acá el foco es otro: cómo saber, a los 30, 60 y 90 días, si esa implementación ya se estabilizó.
Qué significa que una implementación CMMS “funcionó”
La implementación técnica termina cuando el sistema está configurado: activos cargados, tipos de OT definidos, usuarios con permisos, preventivos programados. Es un hito del proyecto y se puede tildar en una lista. La estabilización es otra cosa. Se alcanza cuando, dentro del alcance acordado, el CMMS es el único lugar donde queda registrado el trabajo de mantenimiento y el equipo puede tomar decisiones con lo que el sistema muestra.
Las tres capas se revisan en orden porque cada una depende de la anterior. Auditar la calidad de los cierres no tiene sentido si la mitad de los trabajos ni siquiera llega al sistema. Evaluar si la programación semanal sale del CMMS tampoco, si las OT que la alimentan están imputadas a “planta general”.
| Capa | Pregunta que responde | Se ve en | Decisión que habilita |
|---|---|---|---|
| Adopción real | ¿El trabajo que se hace queda registrado en el sistema, a tiempo y por quien lo hizo? | Cobertura de registro, latencia de cierre, cierre por rol y turno | Dejar de cargar en paralelo y reducir el acompañamiento en campo |
| Calidad de datos | ¿Lo registrado sirve para reconstruir qué pasó con cada activo? | Activo correcto, cierres completos, repuestos asociados a OT | Congelar la estructura del piloto y usar el historial para decidir |
| Control operativo | ¿La semana se planifica, programa y controla desde el CMMS? | Preventivos generados por el sistema, backlog depurado, paralelos dados de baja | Cerrar el acompañamiento intensivo y extender el rollout |
Métricas que parecen de éxito y no lo son
Casi todos los informes de avance de una implementación muestran métricas de actividad del proyecto. Son útiles para saber si el proyecto se mueve, pero leídas como resultado engañan.
| Métrica de actividad | Qué muestra en realidad | Qué medir en su lugar |
|---|---|---|
| Usuarios activos o cantidad de logins | Que alguien entró al sistema, no que cargó algo útil | OT cerradas por el ejecutor, por rol y por turno |
| Cantidad de OT creadas | Actividad. Puede inflarse con OT administrativas, duplicadas o cargadas en lote a fin de mes | Cobertura de registro medida por muestreo |
| Activos cargados | Avance de la migración | OT con el activo correcto en el nivel de la jerarquía acordado |
| Módulos habilitados | Alcance contratado | Reportes del CMMS que se usan en la reunión semanal |
| Horas de capacitación dictadas | Un insumo del proyecto | Cierres aprobados en la primera revisión del supervisor |
Imaginá una planta que da por cerrada la implementación porque el volumen de OT creció mes a mes y que, tiempo después, descubre que la planilla de preventivos siguió viva en la computadora del planner. Las OT existían, pero el planner las cargaba una vez ejecutado el trabajo, a partir de la planilla. El sistema registraba el pasado y la planilla seguía decidiendo el futuro.
Por qué un técnico entra al sistema pero no carga lo que hizo es un problema de adopción, con causas propias, y está desarrollado en por qué el equipo técnico deja de usar el CMMS. Acá interesa otra cosa: no confundir actividad con resultado al momento de declarar éxito.
La paradoja del registro: por qué el MTTR o los correctivos pueden empeorar
Hay un efecto que conviene anticiparle al sponsor antes del primer trimestre. Mientras el mantenimiento se registraba en planillas o cuadernos, una parte de los correctivos menores no quedaba anotada: el ajuste de una correa, el reset de un variador, un fusible cambiado a las tres de la mañana. Cuando el técnico empieza a cerrarlos en el CMMS, el conteo de correctivos sube. La frecuencia de fallas sube y el MTBF calculado baja, aunque los equipos se comporten igual que antes.
Con el MTTR pasa algo parecido. Si en la planilla el técnico anotaba “2 h” de memoria y ahora la OT registra el inicio y el fin, el número cambia de naturaleza. Si además la OT abierta absorbe esperas de repuestos, liberación del equipo por producción o permisos de trabajo, el MTTR deja de representar solo el tiempo efectivo de intervención. Lo mismo vale para el cumplimiento de preventivos: cuando el sistema genera todas las rutinas del plan, aparecen como vencidas tareas que la planilla nunca mostraba porque se habían caído de la lista.
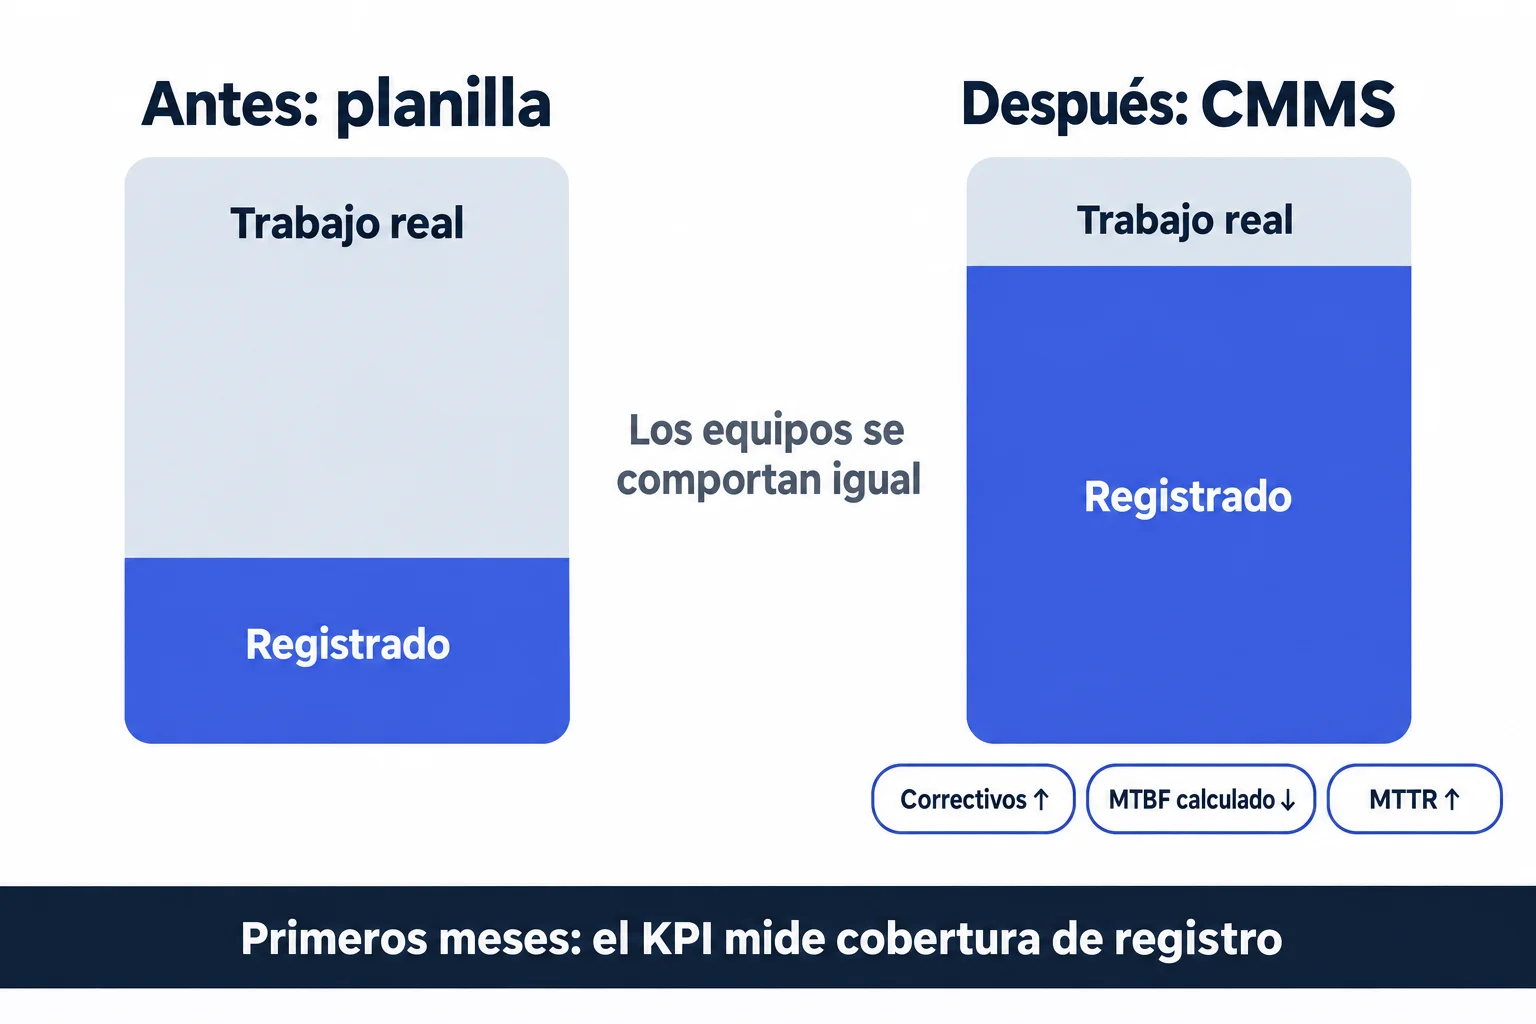
Durante los primeros meses, los KPI de mantenimiento miden sobre todo cuánto se registra. Recién cuando la cobertura se estabiliza empiezan a medir cómo se comportan los equipos.
La recomendación práctica: en la primera etapa no comprometas metas de MTTR, MTBF ni cumplimiento preventivo, y no compares sus valores con los de la época de la planilla. Calculalos, guardalos y tomá como nueva línea base los del período en que la cobertura ya está estable. Qué indicadores usar después y cómo leerlos corresponde a los KPI de mantenimiento industrial.
Antes de medir: línea base y definiciones
Ningún indicador de estabilización se puede leer sin un punto de partida, y el punto de partida casi nunca está en el CMMS: está en lo que había antes. El día del go-live, o en las semanas previas, conviene dejar asentadas cuatro cosas, aunque sea con datos aproximados.
El inventario de sistemas paralelos es el elemento de la línea base que más se omite y el que más pesa en el corte de 90 días. Si no se lista al inicio, nunca se sabe si se terminó de dar de baja.
Además de la línea base, cada indicador necesita una ficha corta. Dos personas que miden “latencia de cierre” con criterios distintos van a discutir el número en lugar de discutir la decisión.
| Campo de la ficha | Ejemplo: latencia de cierre |
|---|---|
| Definición | Tiempo entre el fin de la ejecución del trabajo y el cierre de la OT en el sistema |
| Cálculo | Mediana semanal en horas, por turno |
| Fuente | Reporte de OT cerradas que muestre fecha de ejecución y fecha de cierre |
| Alcance | OT correctivas y preventivas del área piloto. Excluye OT administrativas |
| Frecuencia | Semanal durante el piloto |
| Responsable | Líder funcional del proyecto |
| Umbral de salida | Definido por la operación según turnos y conectividad |
| Decisión que habilita | Reducir el acompañamiento en campo del turno que cumple |
Qué datos tienen que existir desde el arranque para que estas fichas se puedan calcular está en el checklist de datos mínimos para implementar un CMMS. Quién es dueño de cada dato y quién firma cada decisión se define en el equipo de implementación CMMS.
Capa 1: adopción real
Adoptar el sistema es que el trabajo hecho quede registrado, por quien lo hizo y cerca del momento en que lo hizo. Con cuatro indicadores alcanza para verlo.
| Indicador | Cómo se calcula | Señal de alerta |
|---|---|---|
| Cobertura de registro | Trabajos verificados en una muestra externa que tienen OT, sobre el total de trabajos de la muestra | Valor bajo y persistente en un turno o en un tipo de trabajo |
| Latencia de cierre | Mediana de horas entre el fin de la ejecución y el cierre en el sistema | Cierres concentrados al final del turno o de la semana: carga de memoria |
| Cierre por rol y turno | Proporción de OT cerradas por el técnico que ejecutó, frente a las que cierra un supervisor o un administrativo por otros | Una sola persona cierra por todo el turno |
| Origen de la carga | OT cerradas desde el móvil en campo frente a las cargadas después desde escritorio | Uso móvil casi nulo en un alcance pensado para cierre en campo |
La latencia se mide con la mediana y no con el promedio porque una sola OT olvidada durante tres semanas arrastra el promedio y esconde lo que hace la mayoría. Si la operación trabaja sin señal en parte del predio, la latencia tiene que calcularse con la hora de ejecución registrada en el dispositivo y no con la hora de sincronización. Si no, el indicador castiga al técnico por la falta de cobertura. Cuándo ese escenario justifica operación offline está analizado en CMMS con app móvil offline.
Cómo medir lo que no está en el sistema: auditoría de cobertura por muestreo
El indicador más importante de la capa es el más difícil: qué parte del trabajo real llega al CMMS. El problema está en el denominador, porque los trabajos que no se registraron justamente no aparecen en ningún reporte del sistema. La salida es contarlos desde afuera, con fuentes que registran el mismo trabajo por otro camino.
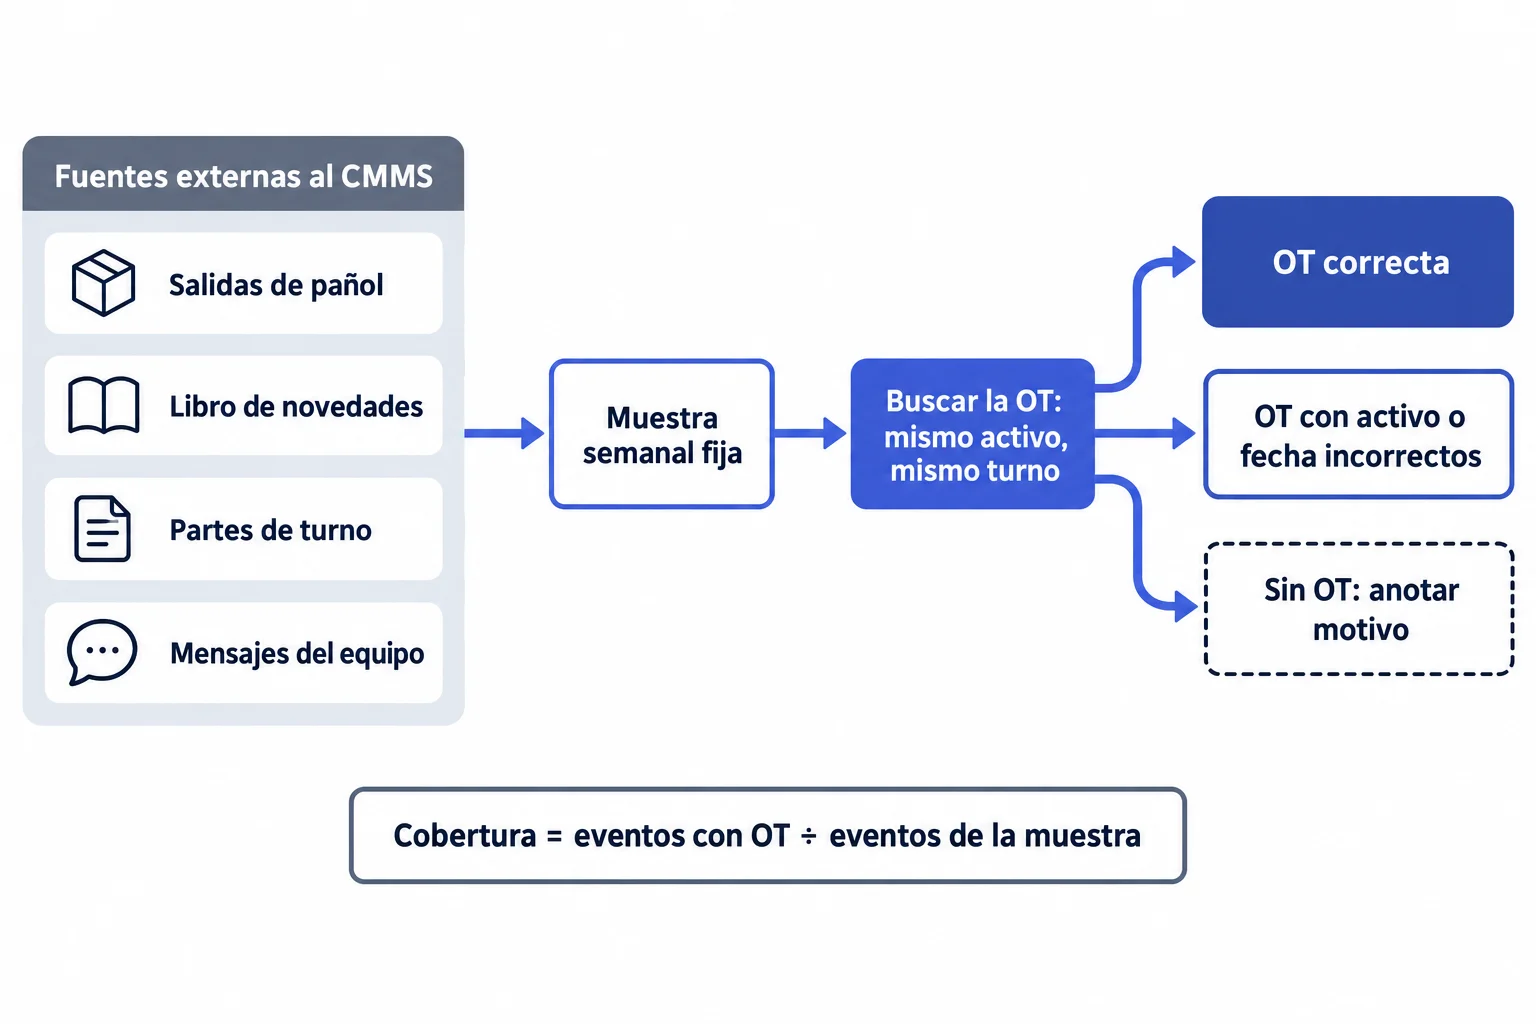
Salidas de pañol, libro de novedades de producción, registro de paradas, partes de turno, pedidos a contratistas o el grupo de mensajería del equipo. Conviene usar al menos dos, porque cada una ve un tipo distinto de trabajo.
Un número de eventos al azar que un supervisor pueda revisar en menos de una hora. Siempre el mismo número y las mismas fuentes, para que las semanas se puedan comparar.
Mismo activo y fecha dentro del turno. Clasificá cada evento en tres grupos: con OT correcta, con OT pero con activo o fecha equivocados, o sin OT.
Urgencia nocturna, trabajo de contratista, intervención menor, falta de dispositivo o de señal. El motivo vale más que el porcentaje, porque indica dónde está la fricción.
Una semana mala puede ser una parada o una guardia atípica. Lo que define el corte es que la cobertura se sostenga varias semanas seguidas y en todos los turnos.
Las salidas de pañol tienen un matiz. Si el pañol ya exige un número de OT para entregar un repuesto, esa fuente siempre va a tener OT y deja de servir para medir cobertura. Pasa a servir para medir calidad: permite controlar si el repuesto quedó imputado al activo correcto. En ese caso, la cobertura hay que buscarla en fuentes donde el trabajo puede ocurrir sin pasar por el sistema, como el libro de novedades o los mensajes. Esas mismas fuentes son las que aparecen en las señales de mantenimiento gestionado por WhatsApp y Excel.
Capa 2: calidad de datos de OT y activos
Una OT puede existir y aun así no servir. La norma ISO/IEC 25012, que define un modelo de calidad de datos, distingue entre otras características la exactitud, la completitud, la consistencia y la actualidad. Esas cuatro alcanzan para revisar el dato de mantenimiento en una estabilización, siempre que cada una se traduzca a algo que se pueda contar en el CMMS.
| Característica | Indicador en el CMMS | Cómo se revisa | Qué análisis arruina si falla |
|---|---|---|---|
| Exactitud | OT de la muestra con el activo correcto en el nivel de jerarquía acordado | El supervisor contrasta la OT con lo que sabe que se intervino | Historial por equipo, fallas por activo, costo por activo |
| Completitud | OT cerradas con acción realizada, tiempo, repuestos y causa cuando el tipo de OT la exige | Filtro de campos vacíos y lectura de textos genéricos ("ok", "se reparó") | Análisis de reincidencia y de modos de falla |
| Consistencia | Salidas de pañol asociadas a una OT; altas de activos duplicadas en el período | Cruce entre movimientos de pañol y OT; revisión de altas nuevas | Consumo de repuestos y costo de mantenimiento por activo |
| Actualidad | Latencia de cierre y OT "en ejecución" sin movimiento durante varios días | Listado de OT abiertas ordenado por antigüedad del último cambio | Backlog visible y carga real por cuadrilla |
Un ejemplo en una línea de alimentos muestra por qué cada campo importa. Un técnico cierra una OT sobre “Línea 3 - CIP” con el texto “se cambió sello, ok”. La OT existe y suma a la cobertura, pero no sirve: no dice qué bomba del circuito de limpieza falló, no permite saber si es la tercera vez en el año, no conecta el sello que salió de pañol con el equipo y mezcla en un solo tiempo la intervención y la espera del repuesto. La misma intervención imputada a la bomba de retorno del CIP, con síntoma, acción, código del sello, tiempo de intervención separado de la espera y foto del sello dañado, alimenta el historial del activo y el análisis de reincidencia. Qué tiene que quedar en cada intervención está desarrollado en el historial de mantenimiento de equipos. Dónde encaja ese cierre dentro del flujo está en el sistema de órdenes de trabajo.
Un indicador merece una lectura aparte: los cierres que el supervisor devuelve por información insuficiente. Si el número es cero, la explicación más probable es que nadie está revisando, no que los cierres sean perfectos. Si es alto y no baja con las semanas, el problema suele estar en el formulario (demasiados campos, opciones que no corresponden al trabajo real) o en una competencia que no se adquirió, y cada caso se resuelve en un lugar distinto.
Medir la calidad no es lo mismo que diseñarla. Cómo armar catálogos, reglas de validación y controles contra duplicados es un tema propio del gobierno de datos del CMMS. En la estabilización alcanza con medir si lo acordado se está cumpliendo.
Capa 3: control operativo desde el CMMS
La tercera capa se nota cuando las decisiones de la semana salen del sistema. Ya no se mide si el trabajo se registra ni si el registro es bueno, sino si el CMMS se volvió la herramienta con la que se gestiona.
La última señal es la que más cuesta. Una planilla sobrevive porque alguien confía más en ella que en el sistema, casi siempre porque le muestra algo que el CMMS todavía no le muestra con la misma comodidad. Prohibirla rara vez funciona. Funciona más identificar qué vista le falta a esa persona y construirla en el sistema. Una prueba simple: preguntarle al planner de dónde saca la lista de trabajos del lunes. La respuesta dice más que cualquier tablero.
Cómo se separan la planificación y la programación, y qué tiene que mostrar el backlog para cada una, está en planificación y programación de mantenimiento. El criterio para estructurar las rutinas que el sistema debería generar está en el plan de mantenimiento preventivo industrial.
Scorecard 30/60/90: qué revisar y qué decidir en cada corte
Los tres cortes ordenan la revisión del proyecto, no la de cada usuario. Evaluar si cada técnico, planner o supervisor adquirió sus competencias tiene su propio esquema, descripto en el plan de capacitación CMMS por roles. El scorecard mira la operación en conjunto y vincula cada corte con una decisión.
Los plazos son de referencia. En un área con poco volumen de OT o con muchos turnos rotativos, la muestra tarda más en ser representativa y conviene estirar los cortes antes que forzar una salida.
| Corte | Foco | Indicadores que mandan | Criterio de salida | Decisión que habilita |
|---|---|---|---|---|
| Día 30 | Adopción | Cobertura por muestreo, latencia de cierre, cierre por rol y turno | Cobertura sostenida durante varias semanas en todos los turnos, latencia dentro del umbral acordado y sin cierres sistemáticos por cuenta de otro | Dejar de cargar en paralelo las OT correctivas y reducir el acompañamiento en campo |
| Día 60 | Calidad de datos | Activo correcto, cierres completos, salidas de pañol con OT, cierres devueltos | Muestra de cierres revisada por encima del umbral y devoluciones en baja, sin que el supervisor deje de revisar | Congelar la estructura de activos y catálogos del piloto, usar el historial por activo para decidir y preparar la siguiente área |
| Día 90 | Control operativo | Señales de control y estado del inventario de paralelos | Todos los paralelos con baja cumplida y la reunión semanal trabajando con reportes del CMMS | Cerrar el acompañamiento intensivo, extender el rollout y tomar los KPI de mantenimiento de este período como nueva línea base |
Los umbrales numéricos de cada criterio los define la operación con su línea base. Un mismo porcentaje de cobertura puede ser exigente para una planta con guardias nocturnas sin supervisor y laxo para un área de un solo turno con tablet por técnico.
Las tareas concretas para preparar el arranque y sostener las primeras semanas pertenecen a la preparación del go-live. El scorecard no las reemplaza: mide si esas tareas dieron resultado.
Dejá tu email y te lo mandamos, con la ficha de cada indicador y el criterio de salida para completar con tu equipo en la reunión de seguimiento.
Al enviar tu email aceptás nuestra Política de Privacidad.
Qué hacer si un indicador no llega al umbral
El reflejo habitual ante un mal número es repetir la capacitación. A veces corresponde, pero muchas veces el problema está en otro lado y la recapacitación solo consume horas del equipo. Antes de actuar, conviene clasificar el síntoma.
| Síntoma | Causa probable | Dónde se resuelve |
|---|---|---|
| Cobertura baja en un solo turno | El supervisor de ese turno acepta reportes por fuera del sistema, o faltan dispositivos | Refuerzo de la adopción en el equipo técnico |
| Latencia alta en todos los turnos | Formulario de cierre con demasiados campos o sin conectividad en campo | Revisión de la configuración del cierre con usuarios de campo |
| OT imputadas a la línea en lugar del equipo | Jerarquía con nombres ambiguos, demasiado profunda o sin QR en los equipos | Estructura del árbol de activos |
| Cierres incompletos concentrados en ciertas personas | Competencia no adquirida | Refuerzo puntual por competencia |
| Repuestos que salen de pañol sin OT | Pañol entrega sin exigir el número de OT | Acuerdo de proceso entre mantenimiento y pañol, con dueño del dato definido |
| La planilla paralela sigue viva | Falta en el CMMS una vista equivalente o hay desconfianza en el dato | Construir el reporte que falta antes de prohibir la planilla |
Quién revisa el scorecard y cuándo se pasa a los KPI de mantenimiento
Durante el piloto, el scorecard se revisa una vez por semana. El líder funcional lo prepara, los supervisores aportan la muestra de cobertura y la revisión de cierres de su turno, y el sponsor firma la salida de cada corte. El proveedor puede aportar reportes y ayudar a leerlos, pero no debería ser quien declare que la implementación funcionó: es juez y parte.
Cuando se cumple el corte de 90 días, el scorecard no desaparece. Se achica a un control mensual de cobertura y calidad, porque la adopción también se degrada: entra personal nuevo, rota un supervisor o cambia un contratista. A partir de ahí, los indicadores de desempeño pasan a ser los KPI de mantenimiento industrial, calculados sobre una base que ya se puede comparar mes a mes. Si esos indicadores se van a consolidar fuera del sistema, el criterio para no distorsionarlos en el camino está en CMMS con Power BI.
En una implementación por etapas, la salida del piloto es también la plantilla para la siguiente área o planta: mismas definiciones, misma muestra, criterio de salida evaluado por separado.
Si hoy estás entre el día 20 y el día 40 del arranque, el primer paso es el más barato: armar el inventario de sistemas paralelos y tomar la primera muestra de cobertura esta semana. Con esos dos datos, la próxima reunión de seguimiento ya puede discutir una decisión en lugar de un número de logins. Si querés hacer ese ejercicio acompañado, el equipo de servicios de implementación de OTEX da seguimiento operativo después del arranque.
Medí la estabilización con tu equipo, no solo el avance del proyecto
Si estás por arrancar o ya pasaste el go-live, revisemos juntos qué indicadores usar, de dónde sale cada dato y qué criterio de salida tiene sentido para tu operación.